aiDAPTIV TM

オンプレミスで実現する、プライベートかつ高速なLLM 推論と大規模学習

動的MoE 

より高性能なモデルを
ローカルで実行 

より大規模なMoEモデルでは、トークンごとにすべてのパラメータをアクティブ化することなく、対象タスクでより優れた結果を得られる場合があります。 

MoEとは

Mixture of Experts(MoE)モデルでは、Denseモデルの一部の層を、特定分野に特化したエキスパートネットワーク群に置き換えます。 Denseモデルでは、層内のすべてのパラメータが各トークンの演算に使用されます。 MoEモデルでは、ルーターが現在のトークンを評価し、関連性の高い少数のエキスパートのみを選択します。これらは一般にTop-Kエキスパートと呼ばれます。そのトークンの演算を実行するのは、選択されたエキスパートのみです。 これにより、MoEモデルは、任意の時点でアクティブ化するパラメータ数を大幅に上回る総パラメータ容量を持つことができます。 モデルやワークロードによっては、同等規模のDenseモデルと同等のアクティブな演算量を必要とせずに、コーディング、推論、ツール利用、多言語処理、ドメイン固有のタスクでより優れた結果を得られる場合があります。 

Dynamic MoE reduces the memory footprint

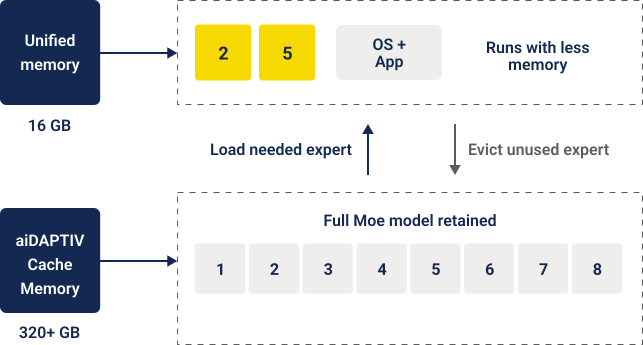
Keep the full model in aiDAPTIV Cache Memory and swap only the experts each token needs into unified memory,

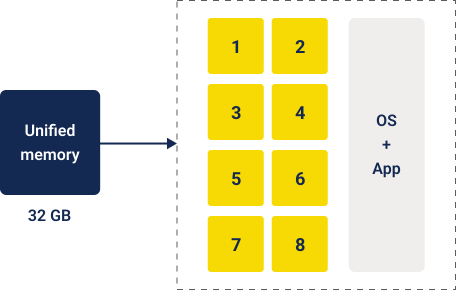
Traditional approach

Without aiDAPTIV, the whole AI model must load
into unified memory.

aiDAPTIV approach

aiDAPTIV offloads the full MoE model to cache and swaps only the needed experts into memory.

Run the same MoE model in roughly half the unified memory – larger models become practical on AI PCs.

注意点は?スパース演算だからといって、必要なメモリ容量が小さいとは限りません。 

特定のトークンの演算に使用されるエキスパートは少数でも、エキスパートプール全体をどこかに保持しておく必要があります。 

総パラメータ数が数千億に達するモデルでも、トークンごとにアクティブ化されるのはその一部にすぎない場合があります。アクティブな演算要件は対応可能な範囲でも、全パラメータのメモリフットプリントが利用可能なGPUメモリまたはユニファイドメモリの容量を超える可能性があります。 

これがMoEのメモリ問題です。

より大規模なMoEモデルをローカルシステムで実用化
practical on local systems

対応する統合環境では、Pascari aiDAPTIV™はアクティブなエキスパートをコンピュートの近くに保持しながら、利用可能なエキスパートプールをGPUメモリ、システムメモリ、キャッシュメモリにわたって拡張します。 

これにより、エキスパートプール全体をGPUメモリまたはユニファイドメモリに収容できないクライアントシステム、ワークステーション、エッジ環境、サーバーでも、より大規模なスパースモデルを実用的に運用できるようになります。

ローカリティが使用感を大きく左右 

タスクによっては、類似したエキスパート群が繰り返し使用されます。その場合、必要なエキスパートのワーキングセットをより多くコンピュートの近くに保持できます。 

一方、ドメイン、言語、コーディングスタイル、ツール、推論モードが短時間で頻繁に切り替わるタスクもあります。その場合、短時間により多くの異なるエキスパートが必要となり、メモリシステム内のデータ移動量が増加します。 

これが中心的なパフォーマンス上のトレードオフです。 

動的MoEを使用する前に確認すべき事項 

タスクでは、類似したエキスパートのワーキングセットが繰り返し使用されるか。 

より大規模なモデルの能力は、時折発生するエキスパートのロード遅延に見合うか。 

トークン間のレイテンシには、どの程度の一貫性が必要か。 

対象ランタイムは、必要なエキスパート管理動作をサポートしているか。 

インタラクティブAIが必ずしも対象外になるわけではありません。適合性は、エキスパートのローカリティ、プラットフォーム構成、およびユーザー体験に求められるレイテンシの一貫性によって異なります。 

Disclaimer: When the router selects an expert already resident near compute, the model can continue with minimal additional data movement. When it selects an expert that must be brought forward from system memory or cache memory, computation waits for that expert to arrive. 

The outcome depends on platform memory bandwidth, cache memory throughput, PCIe or interconnect bandwidth, model architecture, router behavior, expert locality, prompt diversity, and runtime implementation.  A larger MoE is worth using only when its added capability matters to the task. aiDAPTIV expands model capacity; it does not guarantee the latency of a fully GPU-resident model. 

SEAMLESS INTEGRATION

  • Optimized middleware to extends GPU memory capacity
  • 2x 2TB aiDAPTIVCache to support 70B model
  • 低遅延

HIGH ENDURANCE

  • 業界をリードするDWPD 5 年以内に 1 日あたり 100 回の書き込み
  • 高度な NAND 修正アルゴリズムを備えた SLC NAND

aiDAPTIV+ BENEFITS

  • 簡単に実装
  • AI アプリケーションを変更する必要はありません
  • Reuse existing HW or add nodes

aiDAPTIV+ MIDDLEWARE

  • モデルを分割して各GPUに割り当てる
  • Hold pending slices on aiDAPTIVCache
  • Swap pending slices w/ finished slices on GPU

FOR SYSTEM INTEGRATORS

  • Access to ai100E SSD
  • Middleware library license

  • Full Phison support to bring up