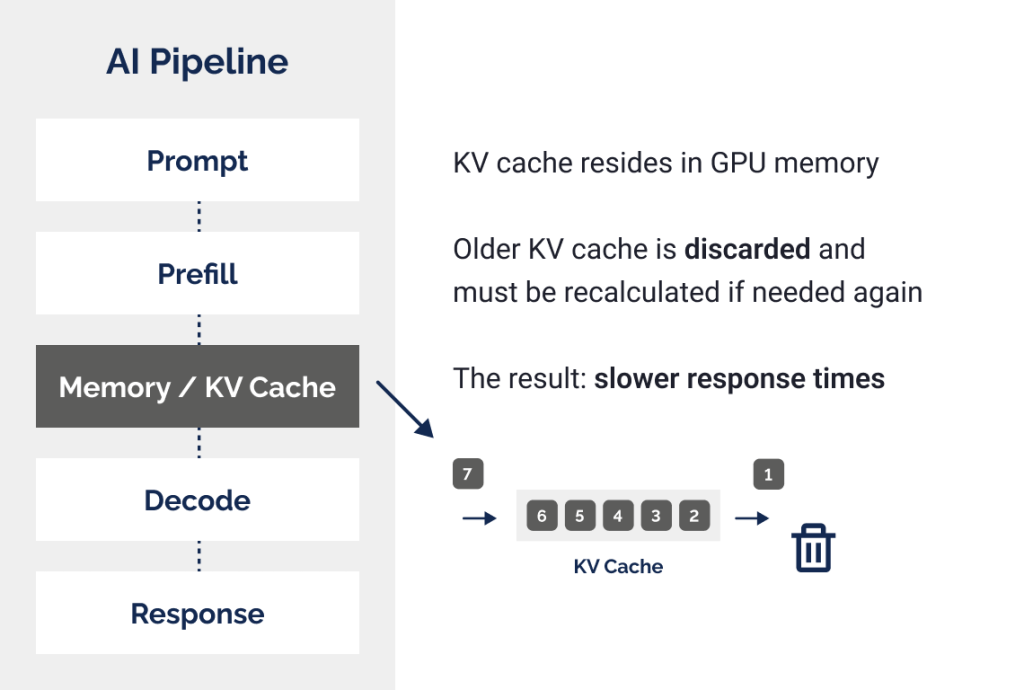
モデルが各トークンを処理する際、アテンション層はそのトークンのキー表現とバリュー表現を生成します。次のトークンが入力されると、モデルは、それ以前のすべてのトークンについて再計算するのではなく、保存されたキー表現とバリュー表現を使用します。この保存されたアテンション状態がKVキャッシュです。 KV cache.
KVキャッシュは、ソースドキュメント、チャット履歴、RAGインデックス、エージェントプランそのものではありません。これらはアプリケーションデータとして保持されます。 KVキャッシュは、モデルがすでに処理したトークンに対するモデル内部の作業状態です。
保持される各トークンは、KVキャッシュのメモリ容量を消費します。 必要な総容量は、以下の要因に応じて増加します。
長いドキュメント、大規模なRAG入力、多数のツールを使用するエージェント、大量のコードコンテキスト、長時間のプロジェクトセッションでは、利用可能なGPUメモリまたはユニファイドメモリに収まらないほど、アクティブなKVキャッシュの需要が増大する可能性があります。
実行中のワークロードで、高速メモリに収まる容量を超えるKVキャッシュの保持容量が必要になります。
関連するタスクで、変更されていない同一の入力に対してプリフィルが繰り返し実行されます。
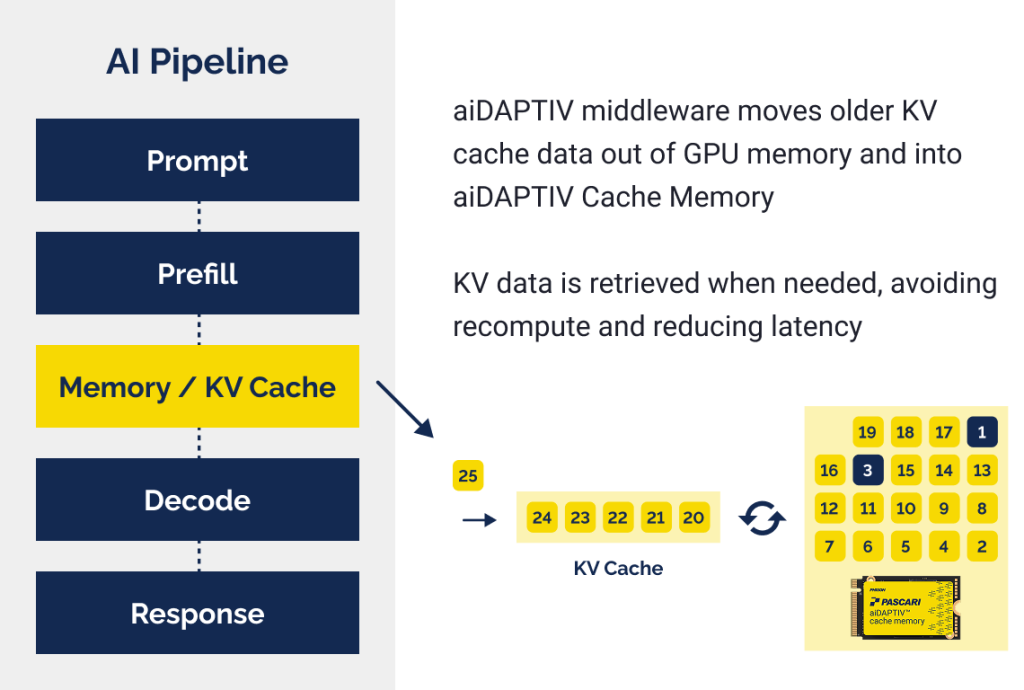
Pascari aiDAPTIV™は、対応するワークロードにおいて、高速メモリの容量が制約されている場合でも、対象となるアクティブ度の低いKVキャッシュの状態をすぐに破棄するのではなく、GPUメモリ、システムメモリ、キャッシュメモリにわたって保持できるようにします。
GPUメモリまたはユニファイドメモリは、引き続きアクティブな演算階層として機能します。 下位階層は保持容量を追加するものであり、フラッシュをGPUメモリと同等の性能にするものではありません。
KVキャッシュの再利用は、トークンの一致に依存します。
共有するトークンシーケンスは、プロンプトの先頭から再利用する部分まで一致している必要があります。最初に不一致が生じた時点で、そのシーケンスの残りの部分は再利用できなくなります。
2つのプロンプトが意味的に類似していても、トークンの順序、句読点、フォーマット、ツール定義、ドキュメントの順序、またはシステムプロンプトが異なる場合、キャッシュを再利用できないことがあります。
そのため、プロンプトの構造が重要になります。安定したシステムプロンプト、固定されたツール定義、長いソースドキュメント、固定されたコンテキストブロック、または再現可能なエージェント構成により、有用な再利用可能プレフィックスを作成できます。
再利用可能なプレフィックスが一致すると、処理済みのコンテキスト部分の再計算を回避できます。
新しい質問、変更されたサフィックス、ツールの応答、またはエージェントの次のステップについては、引き続き処理が必要です。
再利用は、ランタイムのサポートと互換性のある入力に依存します。アプリケーションでは、共有するデータを一定の順序で維持し、変更される入力をその後に追加する必要があります。
To maximize reuse, keep shared instructions, tools, and documents at the beginning and place changing input (questions, tasks, or steps) at the end.
従来のRAGでは、クエリごとに取得したチャンクを異なる順序で組み立てると、再利用が制限される場合があります。
キャッシュを考慮したRAGワークフローでは、関連するデータを固定されたコンテキストブロックに整理します。各ブロックのKVキャッシュ状態を保持し、新しい質問に関連するデータを取得して、互換性のあるブロックを安定したプレフィックスとして選択し、その後に現在の質問を追加できます。
これにより、検索や推論が不要になるわけではありません。 関連する質問が同じ基礎データに依存する場合に、処理の繰り返しを削減します。
Still retrieves and reasons; reduces repeat work.
エージェントは、多くの場合、以下のループで処理を進めます。
各ステップでは、システム指示、ツールスキーマ、検索結果、データベースからの応答、取得したドキュメント、中間出力、作業用アーティファクト、サブエージェントからの出力が追加される場合があります。
当初は小規模なコンテキストウィンドウで始まったタスクでも、最終結果が得られる前に、長時間にわたるメモリ問題へと発展する可能性があります。
KVキャッシュの拡張と再利用は、関連する処理間で重要なコンテキストが安定して維持される場合に最も有効です。
一方、すべてのプロンプトが最初のトークンから変化する場合、共有プレフィックスが短い場合、コンテキストがほとんど再利用されない場合、またはランタイムが必要なキャッシュ動作をサポートしていない場合は、効果が限定的です。
aiDAPTIVが、対象となるKVキャッシュの保持容量を拡張し、ドキュメント、RAG、コーディング、エージェントの各ワークフローで、互換性のある共有入力を再利用する仕組みをご覧ください。



 English English
 繁體中文
 简体中文
 日本語