aiDAPTIV TM

オンプレミスで実現する、プライベートかつ高速なLLM 推論と大規模学習

PASCARI aiDAPTIV™の仕組み 

How Pascari 
aiDAPTIV™ Works 

アクティブなAI状態をコンピュートの近くに保持 

システムの最も高速なメモリには、アプリケーションが後で必要とする可能性のあるすべてのAI関連データではなく、モデルが現時点で必要とするデータを保持する必要があります。通常、これにはモデルコンポーネント、アクティブなKVキャッシュ、アクティブなMoEエキスパート、アクティベーション、および即時の演算に必要なその他のデータが含まれます。  

高速メモリの容量には限りがあります。モデルの重み、コンテキスト、アクティブなアプリケーション状態がその容量を奪い合うと、システムはデータを削除または再計算するか、別の場所に移動する必要があります。  

aiDAPTIV= Middleware + Flash Memory

aiDAPTIV Middleware

Orchestrates AI data across GPU, DRAM, and flash memory.

aiDAPTIV Middleware

Orchestrates AI data across GPU, DRAM, and flash memory.
aiDAPTIV Cache Memory

Specialized high-speed, high-endurance SSD optimized for AI workloads.
Discrete-GPU system
Unified-memory system

aiDAPTIVはディスクリートメモリシステムとユニファイドメモリシステムに対応 

最新のAIシステムのすべてが、個別のGPU VRAMとシステムDRAMを備えているわけではありません。 

ディスクリートGPUシステムでは、GPUメモリとシステムメモリは物理的に分離された階層です。GPUメモリは高速階層として機能し、システムメモリはステージングや近い将来に必要となるデータのための中間容量を提供できます。  

ユニファイドメモリシステムでは、CPUとアクセラレータが共通の物理メモリプールを共有し、このプールが高速階層として機能します。Intel、AMD、NVIDIA、Appleの各エコシステムでは、クライアントおよびサーバープラットフォームで、これらのアーキテクチャの異なるバージョンが使用される場合があります。 

物理構成は異なっても、制約は同じです。モデルの重み、アクティブなコンテキスト、アプリケーション状態が、コンピュートの近くにある最も高速なメモリを奪い合います。 

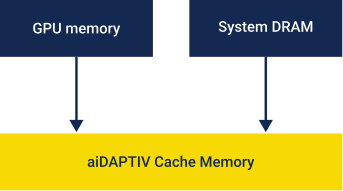
aiDAPTIV キャッシュメモリは、両方のアーキテクチャにおいて、対応するクライアント、ワークステーション、エッジ、サーバー構成で、より大容量の保持容量階層として機能します。これにより、対応するAIランタイムでは、対象となるAI状態を保持できる領域が拡張されます。アクティブなデータは利用可能な最も高速なメモリに保持され、アクティブ度の低い状態は完全に破棄して後で再構築するのではなく、より大容量で低速な階層に保持できます。    

aiDAPTIVTMが対応するトレーニング統合環境では、ワーキングセット全体をGPUメモリに同時に保持するのではなく、モデルおよびトレーニングに必要なメモリをGPUメモリ、システムメモリ、キャッシュメモリにわたってステージングできます。 

具体的な処理方法は、モデル、ランタイム、トレーニング手法、ハードウェア構成、シーケンス長、バッチサイズによって異なります。ワークロードに応じて、容量と実行時間のバランスを取るために、データを保持したり、メモリシステム内で移動したり、再計算したりする場合があります。 

AIデータごとに異なる処理が必要 

すべてのAI処理状態が同じ緊急度を持つわけではありません。 

再利用可能なKVキャッシュのプレフィックスには、互換性のある後続リクエストでプリフィル処理の繰り返しを回避できるという価値があります。MoEエキスパートは、現在のトークンでは非アクティブでも、数トークン後に再び必要になる場合があります。ファインチューニングの状態は、トレーニングジョブの進行に伴ってシステム内を移動する必要があります。 

aiDAPTIVは、これらのワークロードを画一的なメモリページとしてではなく、タイミングや再利用特性が異なるAIデータとして扱います。 

高速階層がいっぱいになると、システムには基本的に3つの選択肢があります。 

1

データを破棄する 

2

後で再計算する

3

より大容量の階層に保持する

aiDAPTIVは、対応するワークロードで3つ目の選択肢を実用化します。即時処理をコンピュートの近くに維持し、対象となるアクティブ度の低い状態をより大容量の階層に保持して、ワークロードで再び必要になったときにその状態を高速階層へ移動します。 

具体的な配置は、モデル、ランタイム、タスクによって異なります。動作原理はシンプルです。高速メモリを即時処理用に確保し、下位階層を使用して容量を拡張し、有用な状態を保持します。 

容量こそが要点 — そしてトレードオフ

下位階層からのデータ移動には時間がかかります。aiDAPTIVはレイテンシをなくすものではなく、フラッシュをGPUメモリと同等にするものでもありません。 

その価値は、より大規模または長時間にわたるAIタスクを実用化し、不要な再計算を回避するとともに、限られた高速メモリを即時処理に集中させることにあります。 

問うべきなのは、キャッシュメモリがGPUメモリと同等の速度かどうかではありません。重要なのは、そのメモリアーキテクチャによって、導入予定のシステム上で目的のAIタスクを実用的に実行できるかどうかです。 

swapとは異なる理由 

swapは、メモリを画一的なページとして扱います。 

AI状態は画一的ではありません。再利用可能なトークンプレフィックス、非アクティブなMoEエキスパート、トレーニング時のアクティベーションでは、それぞれ価値やタイミング要件が異なります。 

aiDAPTIVは、単にバイトデータをストレージへ移動するのではなく、こうした違いを考慮して管理します。

ランタイムとプラットフォームの適用範囲 

機能は、ランタイムとそのバージョン、オペレーティングシステム、GPUまたはユニファイドメモリプラットフォーム、モデルアーキテクチャ、システムメモリ構成、キャッシュメモリ構成、およびAIタスク自体によって異なります。 

KVキャッシュの拡張と再利用
エラスティック・ファインチューニング

SEAMLESS INTEGRATION

  • Optimized middleware to extends GPU memory capacity
  • 2x 2TB aiDAPTIVCache to support 70B model
  • 低遅延

HIGH ENDURANCE

  • 業界をリードするDWPD 5 年以内に 1 日あたり 100 回の書き込み
  • 高度な NAND 修正アルゴリズムを備えた SLC NAND

aiDAPTIV+ BENEFITS

  • 簡単に実装
  • AI アプリケーションを変更する必要はありません
  • Reuse existing HW or add nodes

aiDAPTIV+ MIDDLEWARE

  • モデルを分割して各GPUに割り当てる
  • Hold pending slices on aiDAPTIVCache
  • Swap pending slices w/ finished slices on GPU

FOR SYSTEM INTEGRATORS

  • Access to ai100E SSD
  • Middleware library license

  • Full Phison support to bring up