aiDAPTIV TM

更快速的 AI 推論效能與更大規模的 LLM 訓練,全程於本地部署(On-Prem)私有環境完成

Pascari aiDAPTIV™ 的運作方式 

How Pascari 
aiDAPTIV™ Works 

讓作用中的 AI 狀態靠近運算 

系統最快的記憶體,應該存放模型現在需要的資料,而不是應用程式稍後可能需要的每一項 AI 狀態。這通常包括模型元件、使用中的 KV 快取與MoE 專家、activation,以及即時運算所需的其他資料。  

快速記憶體有限。模型權重、上下文與作用中應用程式狀態競爭該容量時,系統必須移除或重新運算資料,或是將資料移至其他地方。  

aiDAPTIV= Middleware + Flash Memory

aiDAPTIV Middleware

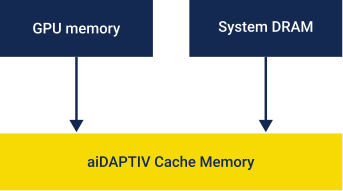
Orchestrates AI data across GPU, DRAM, and flash memory.

aiDAPTIV Middleware

Orchestrates AI data across GPU, DRAM, and flash memory.
aiDAPTIV Cache Memory

Specialized high-speed, high-endurance SSD optimized for AI workloads.
Discrete-GPU system
Unified-memory system

aiDAPTIV 同時適用於獨立記憶體與統一記憶體系統 

新式 AI 系統未必都有獨立的 GPU VRAM 與系統 DRAM。 

在獨立 GPU 系統,GPU 記憶體與系統記憶體是實體上彼此獨立的記憶體層。GPU 記憶體是高速層,系統記憶體可以為暫存或近期資料提供中繼容量。  

在統一記憶體系統,CPU 與加速器共用同一個實體記憶體池作為高速層。在 Intel、AMD、NVIDIA 與 Apple 生態系的用戶端與伺服器平台,都有這類架構的不同版本。 

實體配置雖然不同,但限制仍然相同:模型權重、作用中上下文與應用程式狀態,都在競爭運算位置附近最快的記憶體。 

在支援的情況下,aiDAPTIV 快取記憶體作為較大的保留容量層,可用於兩種架構的用戶端、工作站、邊緣與伺服器配置。這讓支援的 AI 執行階段有更多空間保留符合條件的 AI 狀態。使用中的資料會留在最快的可用記憶體,較少使用的狀態則可留在較大且較慢的層級,而不是立即丟棄這些資料,稍後再重建。    

在支援的訓練整合中,aiDAPTIV 可以透過 GPU 記憶體、系統記憶體與快取記憶體,暫存模型與訓練狀態,而無須將完整的工作集一次全部保留在 GPU 記憶體中。 

確切處理方式因模型、執行階段、訓練方法、硬體配置、序列長度與批次大小而異。視工作負載而定,資料可能會被保留、在記憶體系統中移動,或是重新運算,在容量與執行時間之間取得平衡。 

不同的 AI 資料需要不同處理方式 

AI 狀態的緊急程度不盡相同。 

可重複使用的 KV 快取前綴可能很有價值,因為相容的後續請求可以避免重複的預填充工作。MoE 專家可能在當前 Token 時未被啟用,但幾個 Token 後可能再次被使用。隨著訓練工作進行,微調狀態可能需要在系統中移動。 

aiDAPTIV 將這些工作負載視為具有不同時間與重複使用特徵的 AI 資料,而不是無差異的記憶體分頁。 

高速層填滿時,系統有三個選擇: 

1

丟棄資料 

2

稍後再重新運算

3

將其保留在較大的層級中

aiDAPTIV 讓第三個選項在支援的工作負載派上用場。它將即時工作留在靠近運算的位置,將符合條件但較少使用的狀態保留在更大的層級,並在工作負載再次需要時將該狀態移回。 

確切放置位置因模型、執行階段與任務而異。運作原則依舊簡單:將高速記憶體保留給即時工作,然後使用較低的層級擴充容量並保留有用的狀態。 

容量是關鍵,也是取捨所在

從較低層級移動資料需要時間。aiDAPTIV 無法消除延遲,也無法讓快閃記憶體等同於 GPU 記憶體。 

它的價值在於讓規模更大或更持久的 AI 任務變得實用,避免不必要的重新運算,並讓稀缺的高速記憶體專注於當前的工作。 

問題不在於快取記憶體是否與 GPU 記憶體一樣快。關鍵問題在於,記憶體架構是否讓您在打算部署的系統上,實際執行預期的 AI 任務。 

為什麼這不是 Swap 

Swap 將記憶體視為無差別的分頁。 

AI 狀態並非無差別。可重複使用的 Token 前綴、非作用中的 MoE 專家與訓練活化值,都有不同的價值與時間要求。 

aiDAPTIV 管理這些差異,而不僅僅是將位元組移至儲存空間。

執行階段與平台支援範圍 

功能因執行階段與版本、作業系統、GPU 或統一記憶體平台、模型架構、系統記憶體配置、快取記憶體配置,以及 AI 任務本身而異。 

KV 快取擴充與重複使用
動態 MoE
彈性微調

SEAMLESS INTEGRATION

  • Optimized middleware to extends GPU memory capacity
  • 2x 2TB aiDAPTIVCache to support 70B model
  • 低延遲

HIGH ENDURANCE

  • 業界領先,高達100次的五年內每日寫入次數(DWPD)
  • 採用業界先進NAND 糾錯算法的SLC NAND

aiDAPTIV+ BENEFITS

  • 隨插即用,無縫整合
  • 無需修改現有 AI 應用
  • Reuse existing HW or add nodes

aiDAPTIV+ MIDDLEWARE

  • 模型自動分割與 GPU 資源調度
  • Hold pending slices on aiDAPTIVCache
  • Swap pending slices w/ finished slices on GPU

FOR SYSTEM INTEGRATORS

  • Access to ai100E SSD
  • Middleware library license

  • Full Phison support to bring up