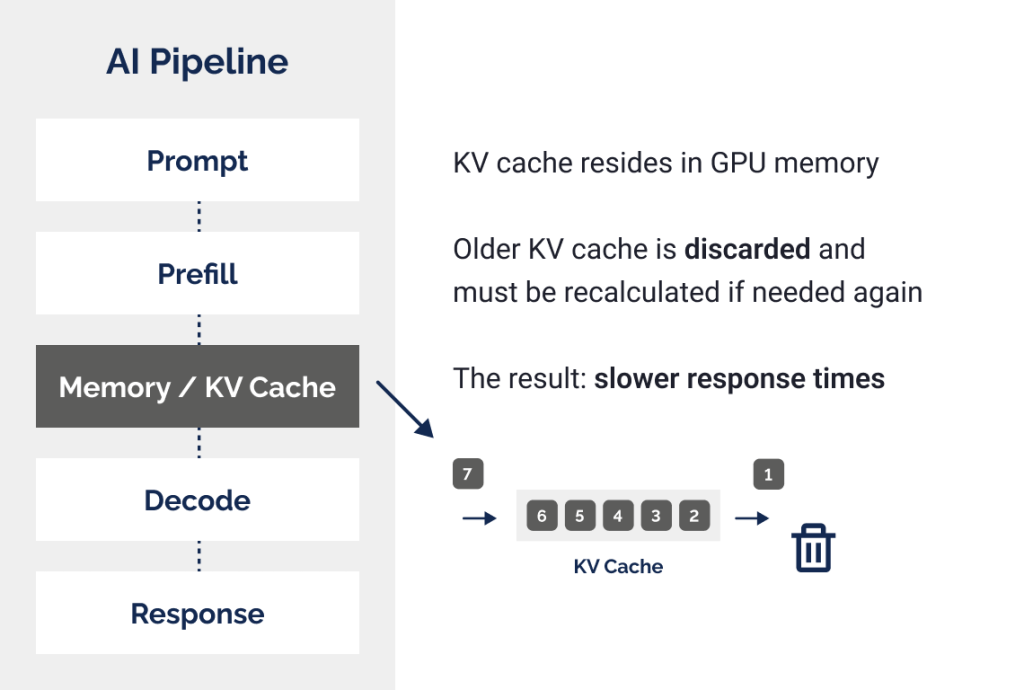
模型處理每個 Token 時,其注意力層會為該 Token 建立key 與 value表示。 下一個 Token 進來時,模型會使用那些已儲存的 key/value,不必重新計算先前所有 Token。 這些被儲存下來的注意力狀態,就是 KV 快取。.
KV 快取並非來源文件、聊天記錄、RAG 索引或Agent計畫本身。這些仍然是應用程式資料。KV 快取是模型針對其已處理 Token 的內部工作狀態。
每個保留的 Token 都會使用 KV 快取記憶體。總需求隨著下列情況增加:
長文件、大型 RAG 輸入內容、工具密集型Agent、大量的程式碼上下文與長時間的專案工作階段,都會讓使用中的 KV 快取超出可用 GPU 或統一記憶體的容量。
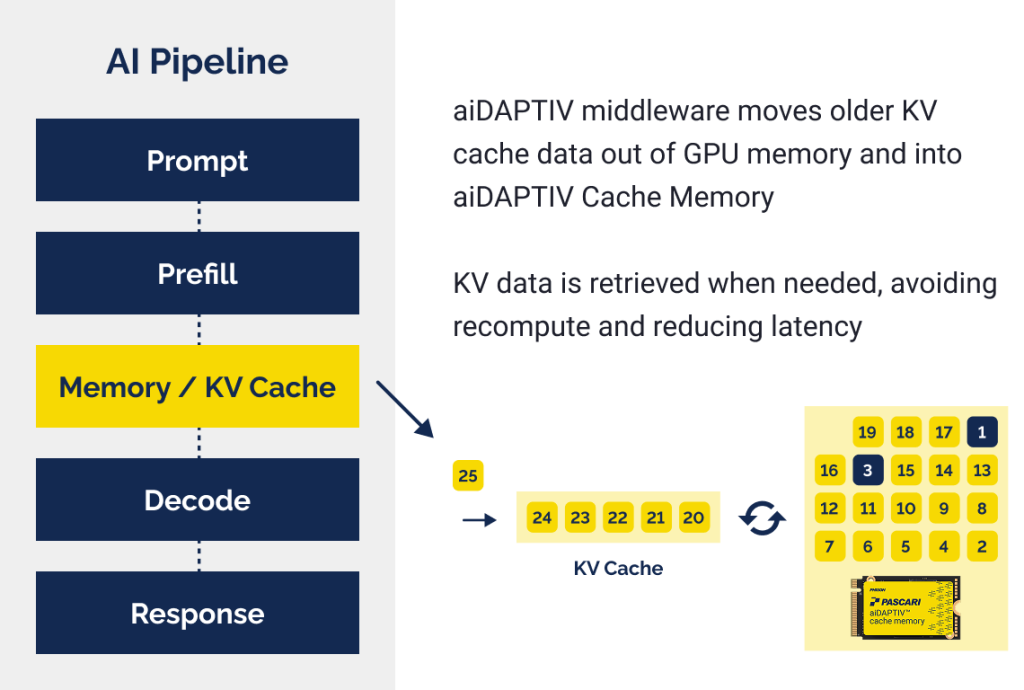
即時工作負載需要保留的 KV 快取容量,超出高速記憶體所能容納
相關任務重複預填充相同的輸入內容
Pascari aiDAPTIV™ 協助支援的工作負載跨 GPU 記憶體、系統記憶體與快取記憶體保留符合條件且較少使用的KV 快取狀態,而不是在高速記憶體容量受限時立即將其捨棄。
GPU 或統一記憶體仍然是作用中運算層。較低層級增加了保留的容量;它們無法讓快閃記憶體達到像 GPU 記憶體一樣的效能。
KV 快取能否重複使用, 取決於 Token 是否完全一致。
共用的 Token 序列,從提示開頭到重複使用的部分都必須相符。一旦出現第一個不相符,後面就無法再重複使用。
即使兩個提示語義相似,但如果其 Token 順序、標點符號、格式設定、工具定義、文件順序或系統提示有所不同,仍無法重複使用快取。
這使得提示結構變得非常重要。穩定的系統提示、固定的工具定義、長來源文件、固定的上下文欄位,或是可重複使用的Agent設定,都能打造可重複使用的實用前綴。
可重複使用的前綴相符時,系統可避免重新運算已處理過的上下文內容。
新問題、變更後的後綴、工具回應或下一個Agent步驟仍須處理。
重複使用取決於執行階段支援與相容的輸入。應用程式必須以穩定的順序保留共用內容,並將變更的輸入附加於後方。
To maximize reuse, keep shared instructions, tools, and documents at the beginning and place changing input (questions, tasks, or steps) at the end.
當每次查詢都以不同順序組合檢索到的區塊時,傳統 RAG 的重複使用空間有限。
具備快取感知能力的 RAG 工作流程,會將相關資料整理成固定的上下文區塊。它可以保留每個區塊的 KV 快取狀態,為新問題檢索相關資料,選擇相容的區塊作為穩定前綴,然後將即時問題附加於後方。
檢索或推理並未隨之消失。當相關問題依賴相同的基礎資料時,這種方式可以減少重複工作。
Still retrieves and reasons; reduces repeat work.
Agent通常以循環機制運作:
每個步驟都可以新增系統指令、工具結構描述、搜尋結果、資料庫回應、檢索的文件、中介輸出、工作產出,以及子Agent的輸出。
開頭是適度上下文視窗的任務,在您看到最終結果之前,可能會演變成長期的記憶體問題。
有意義的上下文在相關工作維持穩定時,KV 快取擴充與重複使用最能發揮作用:
若每個提示從第一個 Token 就不同、共享前綴很短、上下文很少重複使用,或者執行階段不支援所需的快取行為時,比較無法發揮作用。
了解 aiDAPTIV 可如何擴充符合條件的 KV 快取保留容量,並且跨文件、RAG、程式設計與Agent工作流程重新使用相容的共享輸入。



 English English
 繁體中文
 简体中文
 日本語