模型处理每个 token 时,其注意力层会为该 token 创建 Key 和 Value 向量。当下一个 token 到来时,模型会使用已保存的 Key 和 Value 向量,而无需重新计算之前所有 token 的相关信息。这些保存的注意力状态就是 KV 缓存。 KV cache.
KV 缓存不是源文档、聊天记录、RAG 索引或智能体计划本身。 这些仍然是应用数据。 KV 缓存是模型针对已经处理 token 保存的内部计算状态。
每个留存的 token 都会占用 KV 缓存内存。总需求会随以下因素增加:
长文档、大 RAG 输入、频繁使用工具的智能体、庞大的代码上下文以及长时间项目会话,会生成大量活跃 KV 缓存,这可能超出 GPU 内存或统一内存的承载能力。
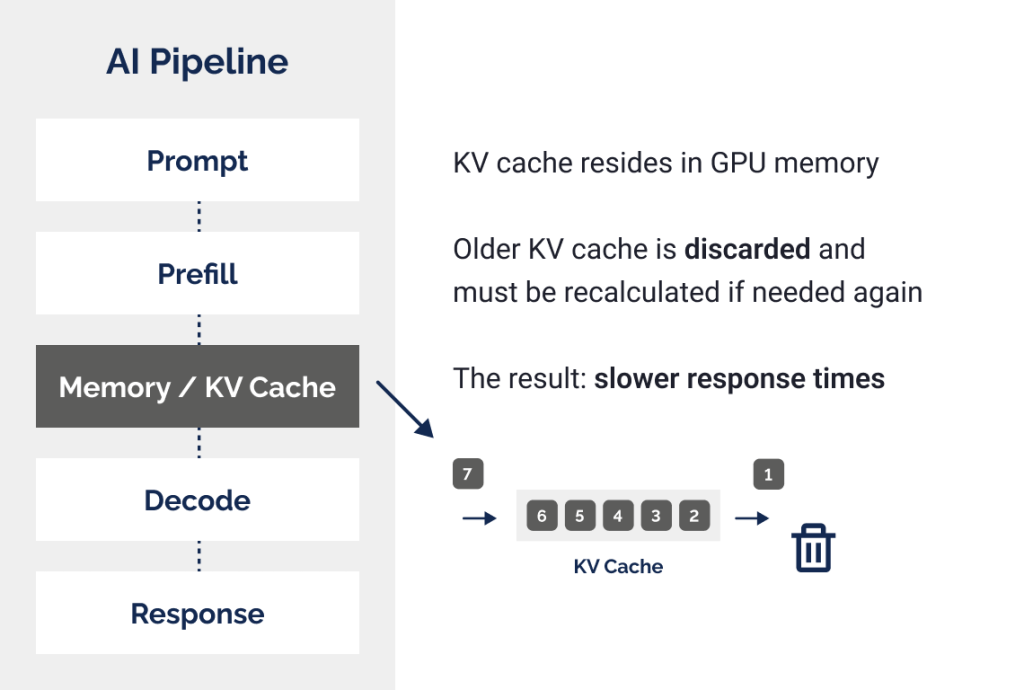
当前运行的工作负载需要保留的 KV 缓存超出高速内存可提供的空间。
相关任务会重复预填充相同输入。
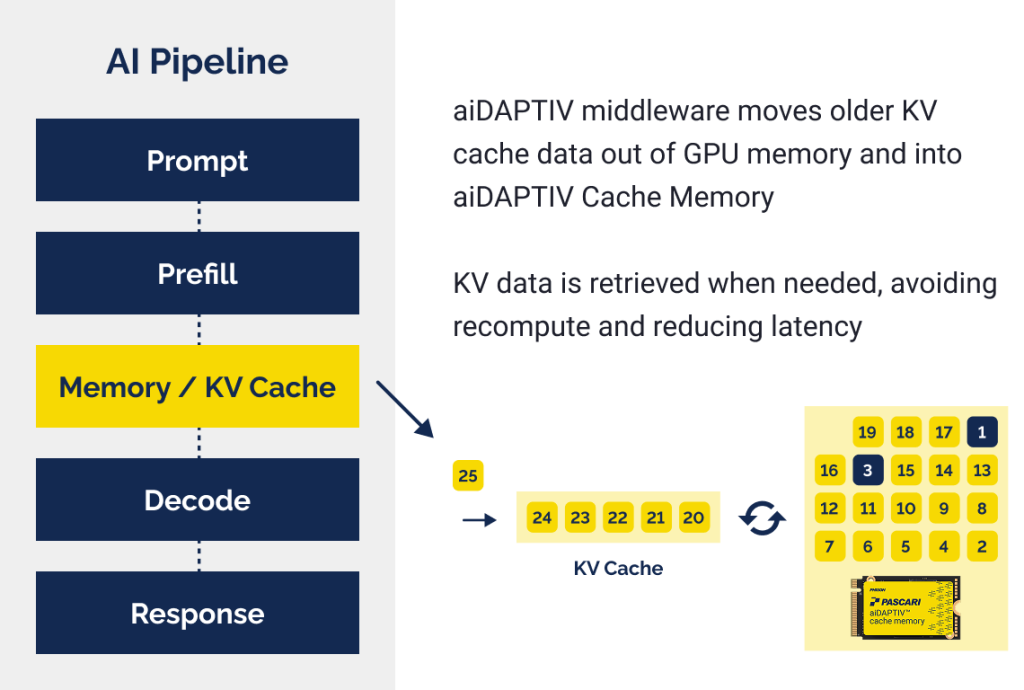
Pascari aiDAPTIV™ 可帮助兼容的工作负载在 GPU 内存、系统内存和缓存内存之间保留符合条件且活跃度较低的 KV 缓存状态,而不是在高速内存容量受限时立即丢弃这些状态。
GPU 内存或统一内存仍为主要计算层。较低层级存储增加了留存空间;但它不会让闪存具备 GPU 内存的性能。
KV 缓存复用取决于 token 是否完全一致。
要复用某一段 KV 缓存,该段 token 序列必须从提示词的起始位置往后连续匹配。一旦出现一个不匹配的 token,后续部分就无法复用。
两个提示词可能在语义上非常相似,但如果它们的 token 顺序、标点、格式、工具定义、文档顺序或系统提示词存在差异,仍然无法复用 KV 缓存。
因此,提示词的结构非常重要。稳定的系统提示、固定的工具定义、较长的源文档、固定的上下文块、可重复使用的智能体配置,都能形成有价值的可复用前缀。
当可复用前缀匹配时,系统可以不用重新计算已处理过的上下文,
但仍然需要处理新的问题、变化后的后缀、工具返回结果或智能体的下一步操作。
复用取决于执行环境是否兼容以及输入是否匹配。应用必须以稳定顺序保留共享内容,并将变化的输入追加在后方。
To maximize reuse, keep shared instructions, tools, and documents at the beginning and place changing input (questions, tasks, or steps) at the end.
传统 RAG 在每次查询时会以不同顺序组装检索片段,这会限制 KV 缓存的复用。
面向缓存优化的 RAG 工作流会将相关内容组织成固定的上下文块。它可以保留每个块对应的 KV 缓存状态,在新问题出现时检索相关内容,选择一个满足复用条件的块作为稳定前缀,并将当前问题追加在其后。
这并不消除检索或推理过程,但当相关问题依赖相同的基础资料时,它可以减少重复处理。
Still retrieves and reasons; reduces repeat work.
智能体通常按一个循环运行:
每一步都可能增加系统指令、工具定义、搜索结果、数据库响应、检索文档、中间输出、工作产物以及子智能体的输出。
一个最初只需要较小上下文容量的任务,随着执行过程不断展开,可能在最终结果生成前就造成内存管理压力。
若相关任务依赖相同的核心上下文,KV 扩展和复用最有价值:
若提示词从第一个 token 开始就变化,或共享前缀很短,或上下文很少复用,或执行环境不支持所需的缓存机制,扩展和复用的价值就会降低。
了解 aiDAPTIV 如何保留更多符合条件的 KV 缓存状态,并在文档处理、RAG、编程和智能体工作流中复用满足条件的相同输入。



 English English
 繁體中文
 简体中文
 日本語